Alle Alarme an einem Ort
Netzwerk, Server, Websites, Firewall und die übrigen Bereiche, mit Quelle und Schweregrad.
Produkte Alarme und NOC
Jeder Alarm geht an die Person in Bereitschaft, per WhatsApp, SMS, Teams oder E-Mail; ohne Reaktion wird an die nächste eskaliert. Geplante Wartungsfenster setzen die Alarme aus.
30-minütige Demo · Ohne Kosten pro Gerät
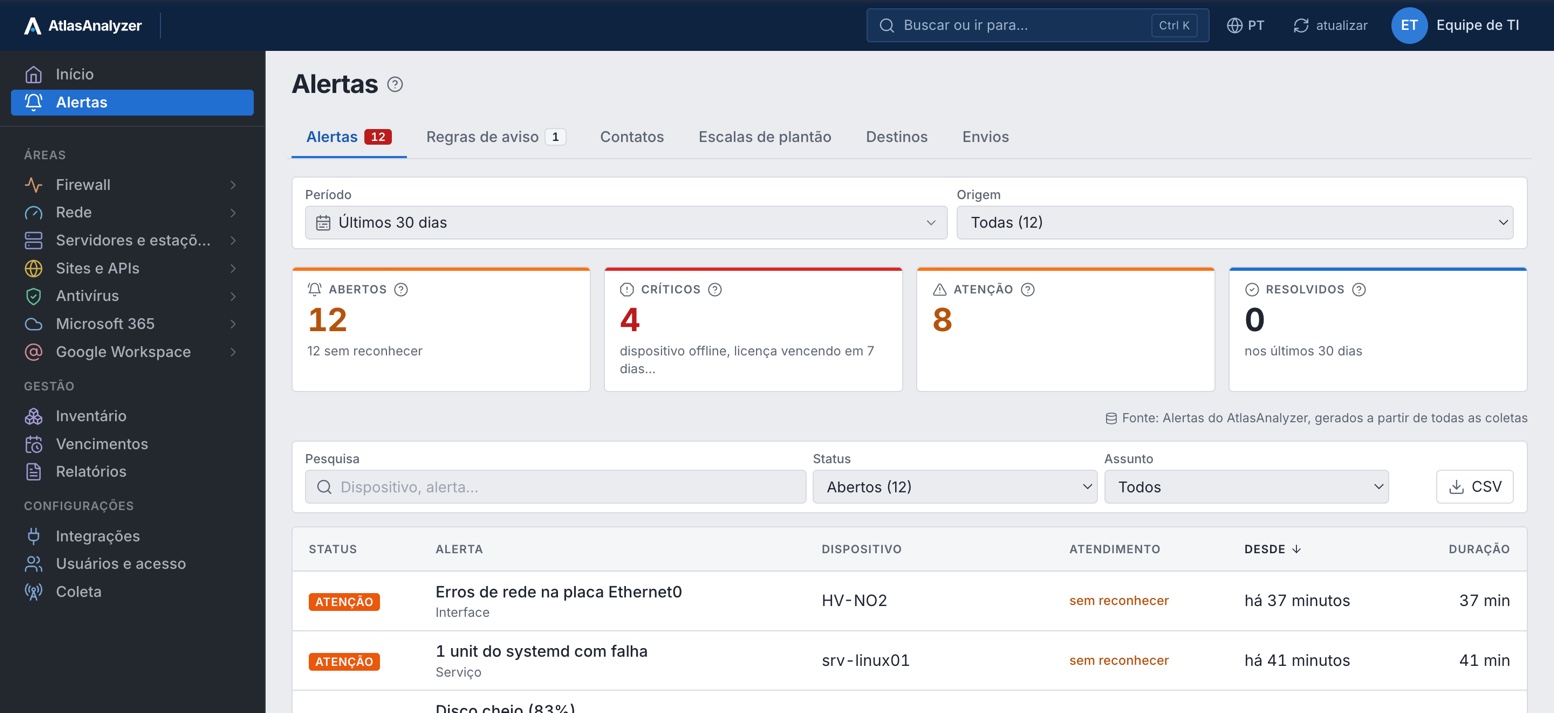
Netzwerk, Server, Websites, Firewall und die übrigen Bereiche, mit Quelle und Schweregrad.
Nur die Ursache meldet sich, eine flatternde Leitung nicht, und Wartung öffnet keine Alarme.
Benachrichtigungsregeln, Bereitschaftspläne und Eskalation, wenn niemand bestätigt.
In GLPI, Tiflux, Milvus, Movidesk, HaloPSA, ConnectWise oder Autotask.
Alarmzentrale
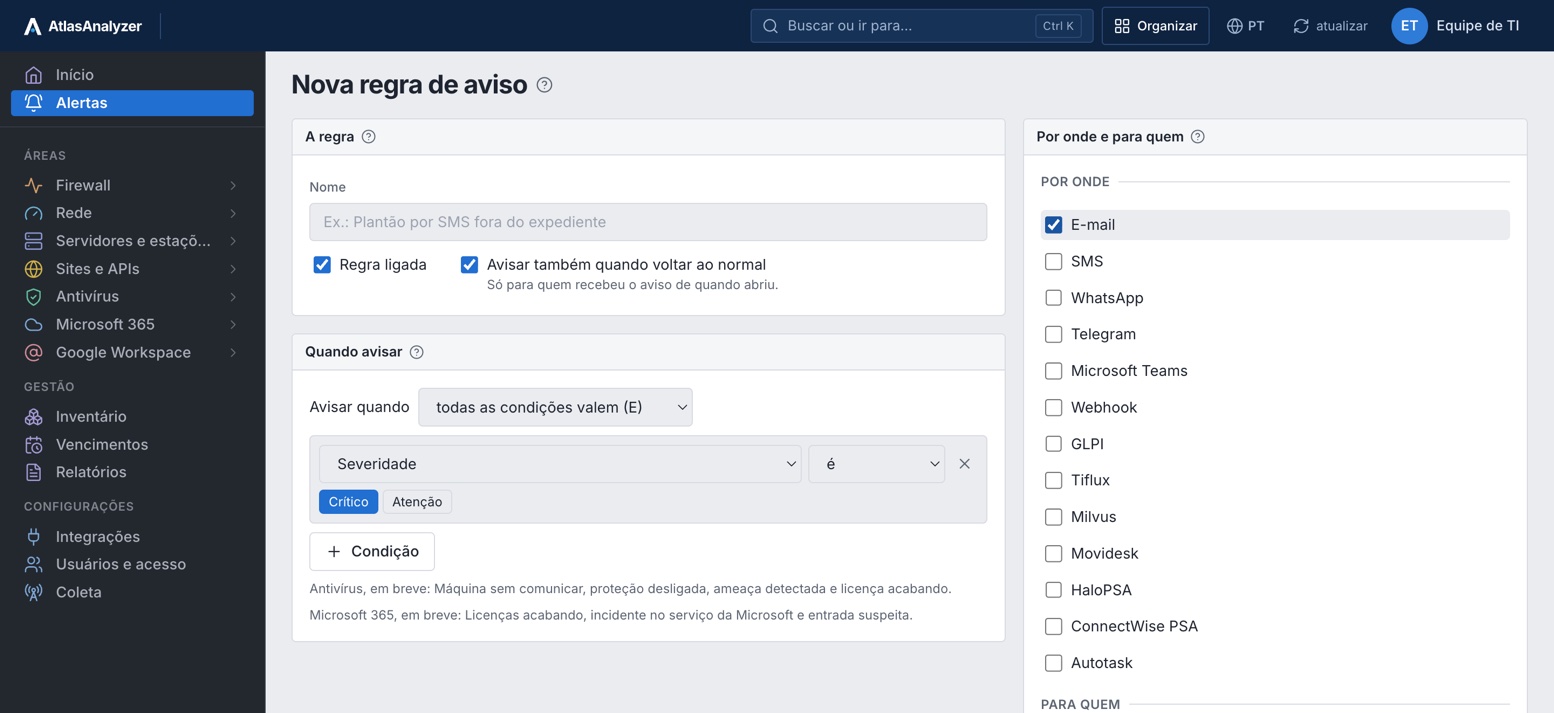
Was passiert ist, die wahrscheinliche Ursache und was zu prüfen ist, mit Übernahme und Kommentaren bis zur Lösung.
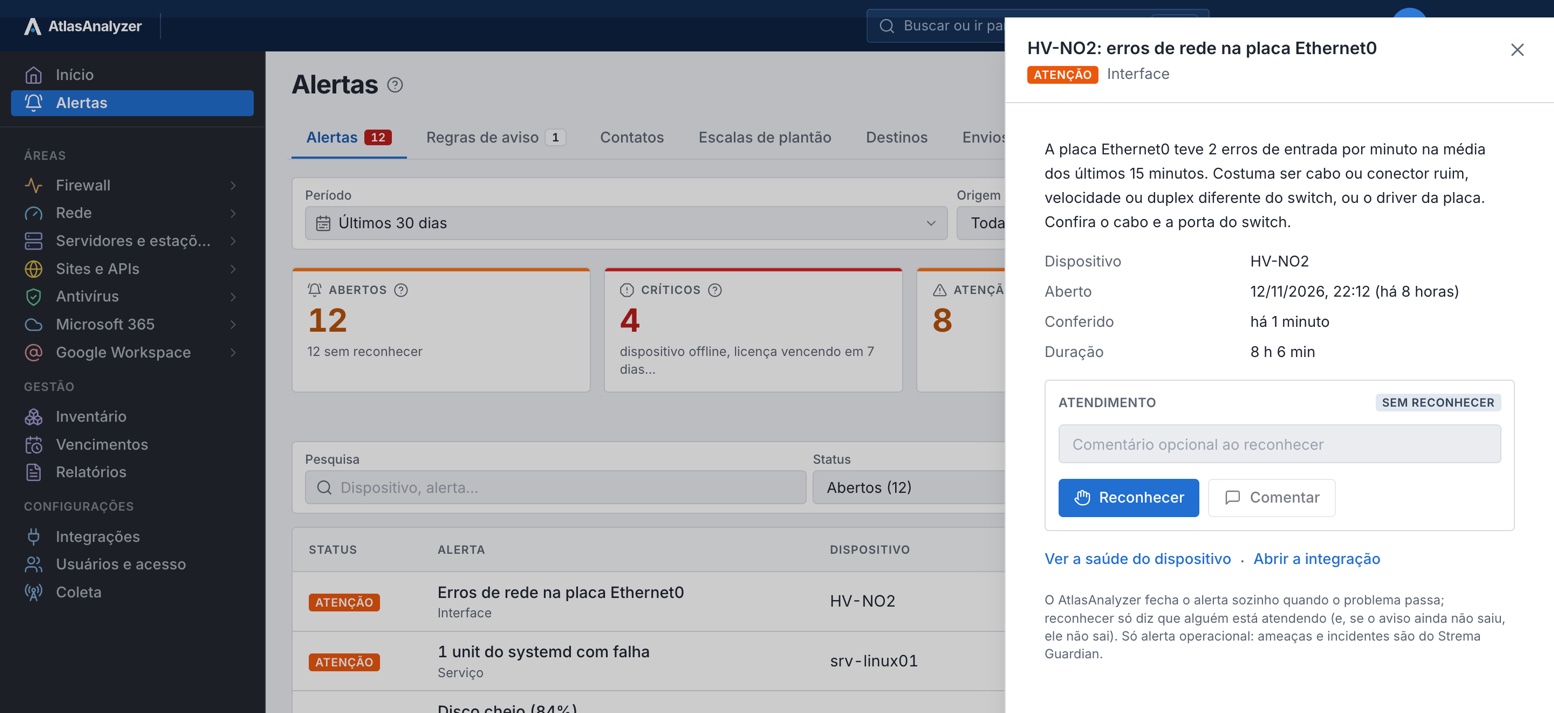
Benachrichtigungsregeln
Kombinieren Sie Bereich, Auslöser, Schweregrad, Gerät, Text, Tag und Uhrzeit, und wählen Sie Kanäle und Empfänger.
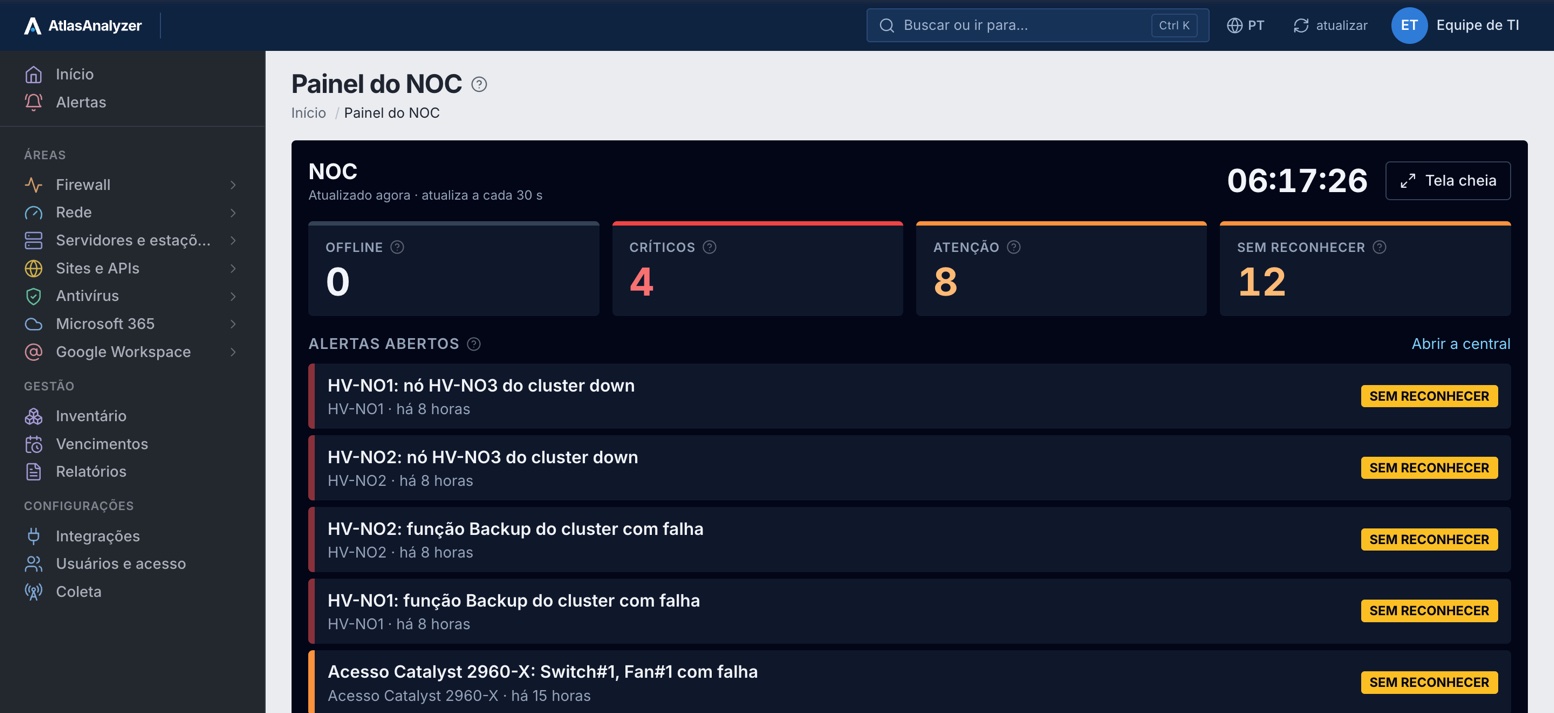
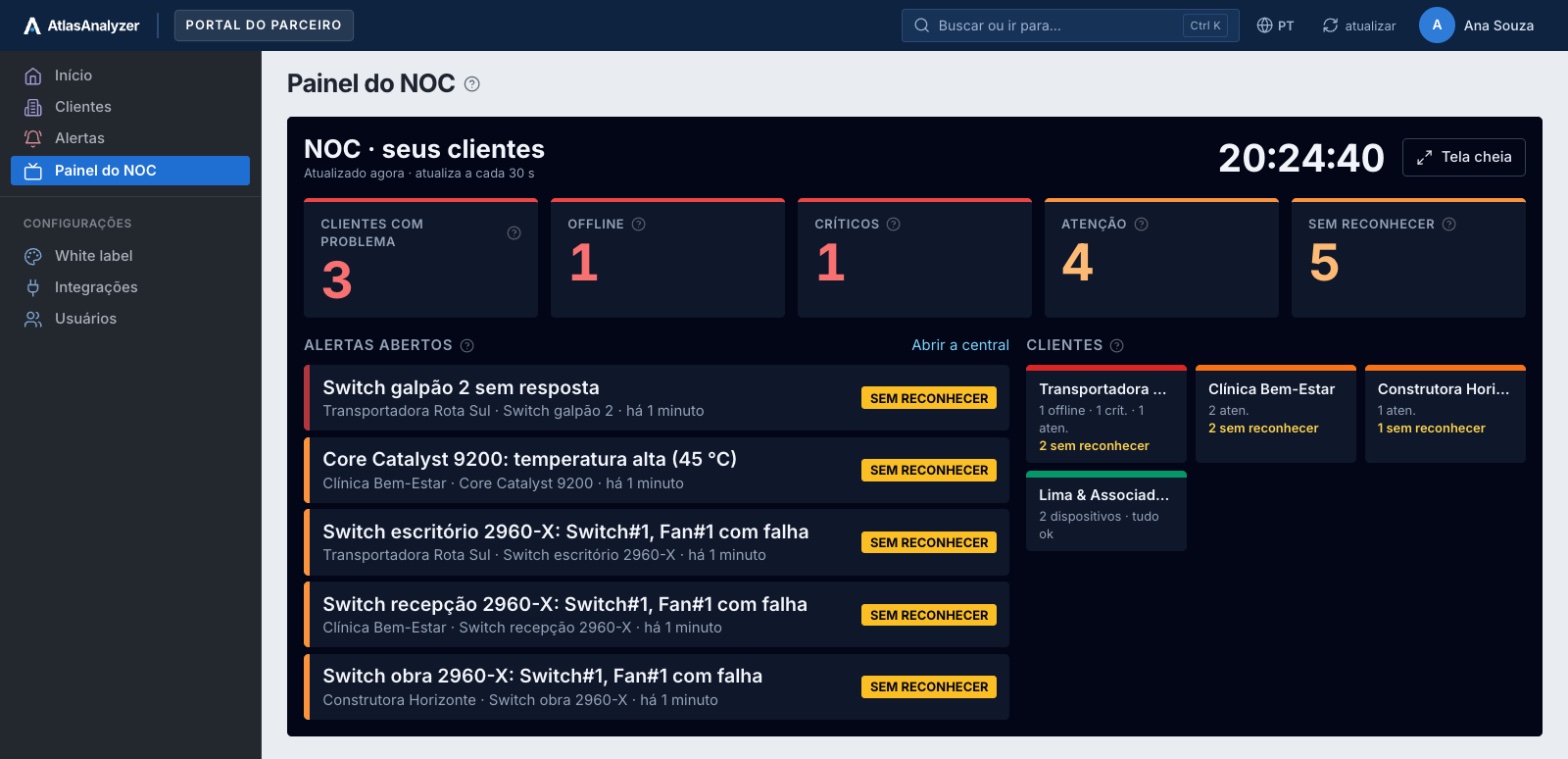
NOC-Panel
Für die Videowand: was offline ist, Kritisches, was Aufmerksamkeit braucht und was niemand bestätigt hat, alle 30 Sekunden aktualisiert.
Für MSPs
Der Partner sieht die Alarme aller Kunden an einem Ort, mit einem NOC für den Kundenstamm und einem Ticketsystem für alle.
Sehen Sie Alarme und NOC mit den Daten Ihrer Umgebung
Alles, was AtlasAnalyzer mit den Alarmen aller Bereiche macht, von der Benachrichtigung bis zum Ticket, in 26 Funktionen.
Die Alarme aller Quellen zusammen, jeweils mit Herkunft, Schweregrad und Status.
Der Alarm öffnet sich, wenn das Problem auftritt, und ist gelöst, wenn sich das Gerät normalisiert.
Wer welchen Alarm übernommen hat, die Kommentare und der Verlauf bis zur Lösung.
Ist die Firewall offline, melden die Geräte dahinter nichts: Nur der Alarm zur Ursache kommt an.
Gerät offline, Schnittstelle, VPN und SD-WAN-Leitung down, SLA auf der Leitung verletzt, HA, ablaufende Lizenz und Syslog angehalten.
CPU, Speicher, Datenträger voll oder läuft voll, Dienst angehalten, IIS, AD, Exchange, Cluster, SQL Server mit wenig Speicher, Blockierungen, Datenbank offline oder überfälligem Backup und Hyper-V-VM kritisch.
Offline, langsam, ungewöhnlich, ablaufendes Zertifikat und ablaufende Domain sowie Monats-SLA verletzt.
Schutz gestoppt, Virenschutz veraltet und Computer ohne Verbindung zur Konsole.
Dienst down oder beeinträchtigt, Lizenzen aufgebraucht, ablaufendes Abonnement und AD-Synchronisierung angehalten.
Ihre eigenen, auf jeder der 61 erfassten Metriken (Leitungsauslastung, SQL Server-Verbindungen, Toner, USV-Laufzeit), mit einer Vorschau der letzten 24 h.
Wer wann benachrichtigt wird, kombiniert aus Bereich, Auslöser, Schweregrad, Gerät, Text, Tag und Uhrzeit.
E-Mail, SMS, WhatsApp, Telegram, Microsoft Teams und Webhook.
Ohne rechtzeitige Bestätigung geht die Benachrichtigung an die nächste Person der Bereitschaft.
Der Alarm muss einige Minuten offen bleiben: Eine Leitung, die kurz ausfällt und zurückkommt, meldet nichts.
Wer über das Problem benachrichtigt wurde, erfährt auch, wenn es sich normalisiert.
Jeder Kontakt erhält Benachrichtigungen in seiner Sprache und Zeitzone.
Was an wen über welchen Kanal gesendet wurde und ob es angekommen ist.
Der Alarm eröffnet ein Ticket in GLPI, Tiflux, Milvus, Movidesk, HaloPSA, ConnectWise oder Autotask, mit Priorität nach Schweregrad.
Übernahme und Eskalation werden zu Ticket-Updates, und die Lösung geht ins Ticket, wenn der Alarm gelöst ist.
Zeitfenster, in denen Geräte weder Alarme auslösen noch in die Verfügbarkeit eingehen.
CPU, Arbeitsspeicher, Festplatte, Inodes, Warteschlangen, SQL Server, Hyper-V, Latenz und Verlust mit dem Grenzwert jedes Geräts.
Vollbild für die Videowall, alle 30 Sekunden aktualisiert, mit dem, was offline ist und was niemand bestätigt hat.
Die durchschnittliche Zeit bis zur Übernahme und bis zur Lösung von Alarmen, im Zeitraum und im Bericht.
Für jedes Gerät, jede Leitung und jede Website, bereit für den Monatsbericht.
Der Partner sieht die Alarme aller Kunden an einem Ort, mit dem NOC für das Portfolio.
Ein Ticketsystem für das gesamte Portfolio, mit der Entität oder dem Kunden jedes Einzelnen.
Betriebsalarme: Gerät offline, VPN down, Festplatte voll, Lizenz läuft ab.
Jede Erfassung eröffnet und schließt ihre eigenen, mit den Grenzwerten jedes Geräts.
Was meldet, über welchen Kanal und an wen.
Rotation oder Schichten, mit Vertretungen; ohne Bestätigung wird eskaliert.
Der Alarm wird zum Ticket, und das Ticket folgt dem Alarm.
Jeder Versand wird protokolliert: was, an wen, über welchen Kanal und ob er ankam.
Eröffnungs- und Lösungsmeldung, in der Sprache des Empfängers
Eine kurze Nachricht mit Gerät und Ereignis
Die Meldung über die Nachrichtenvorlage von AtlasAnalyzer
Die Meldung in einer Gruppe oder an eine Person
Eine Karte im Kanal des Teams, in der Farbe des Schweregrads
Signiertes JSON (HMAC-SHA256) für eröffnet, übernommen, eskaliert und gelöst
GLPI, Tiflux, Milvus, Movidesk, HaloPSA, ConnectWise PSA und Autotask: öffnet ein Ticket mit Priorität nach Schweregrad; Übernahme und Eskalation werden zu Nachträgen, und die Lösung wird eingetragen, wenn der Alarm behoben ist
Ja. Sobald das Gerät wieder normal läuft, ist der Alarm gelöst, und wer benachrichtigt wurde, erhält die Lösungsmeldung.
Eine Regel kann einige Minuten warten: Was in dieser Zeit zurückkommt, meldet sich nicht.
Nein. AtlasAnalyzer dient der Beobachtbarkeit: Die Alarme sind betrieblicher Natur.
Ja. Der Partner sieht die Alarme des gesamten Kundenstamms und nutzt ein Ticketsystem für alle Kunden.
In AtlasAnalyzer Monitor und in Analytics.
In einer 30-minütigen Demo zeigt Ihnen unser Team AtlasAnalyzer mit Beispieldaten der Quellen, die Sie nutzen.
