Todas las alertas en un lugar
Red, servidores, sitios, firewall y las demás áreas, con el origen y la severidad.
Productos Alertas y NOC
Cada alerta va a quien está de guardia, por WhatsApp, SMS, Teams o correo; sin respuesta, escala al siguiente. Las ventanas de mantenimiento programado suspenden las alertas.
Demostración de 30 minutos · Sin cobro por equipo
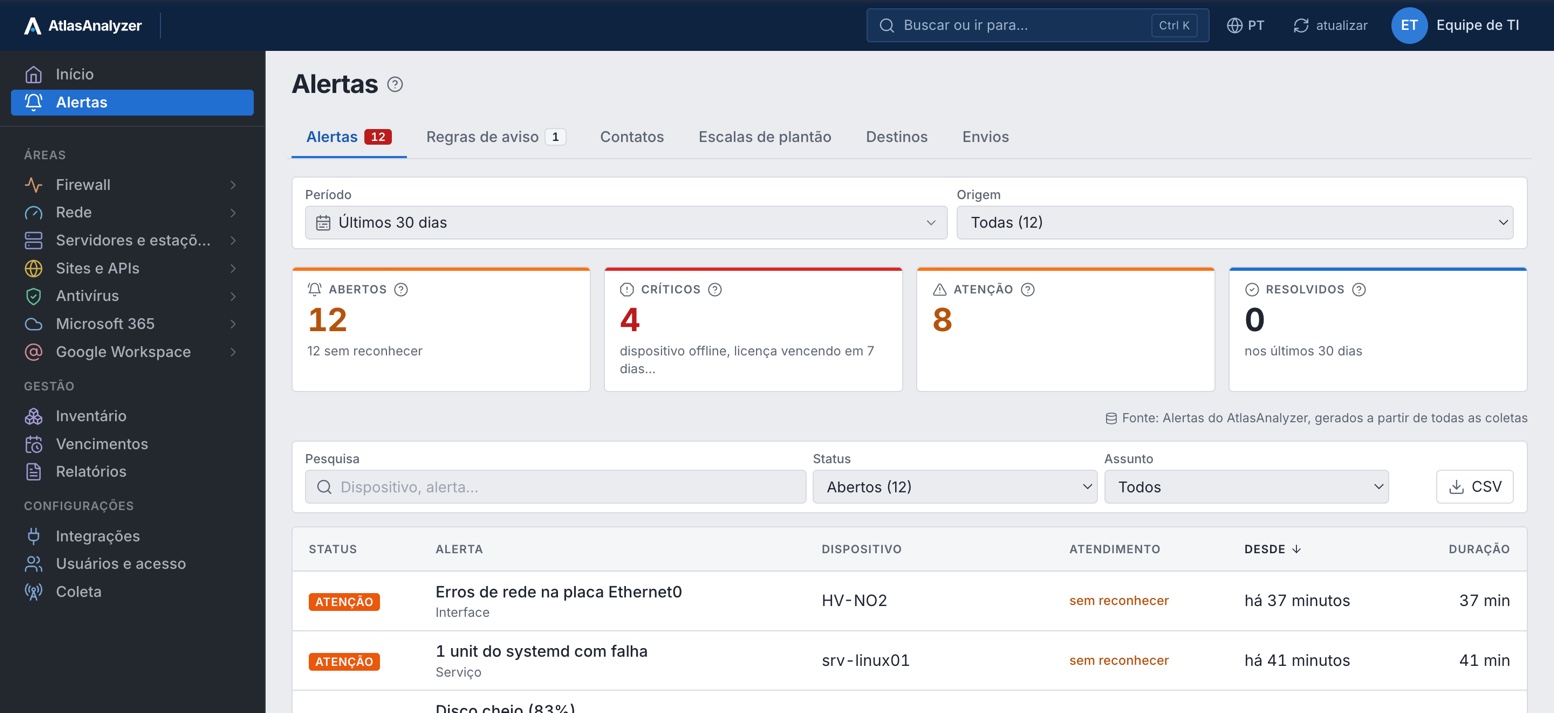
Red, servidores, sitios, firewall y las demás áreas, con el origen y la severidad.
Solo la causa avisa, el enlace que parpadea no avisa y el mantenimiento no abre alertas.
Reglas de aviso, guardia y escalamiento cuando nadie reconoce.
En GLPI, Tiflux, Milvus, Movidesk, HaloPSA, ConnectWise o Autotask.
Central de alertas
Qué pasó, la causa probable y qué revisar, con quién lo asumió y los comentarios hasta resolver.
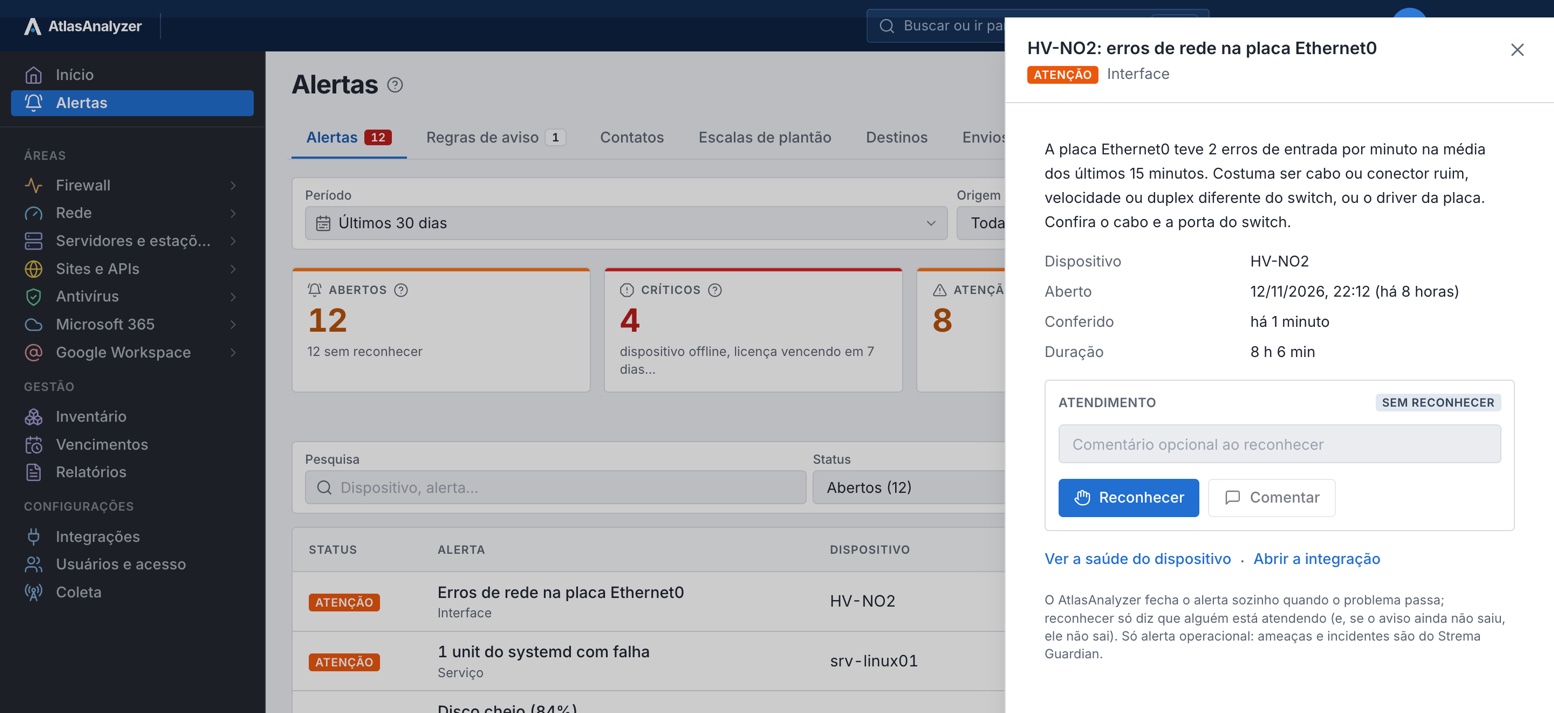
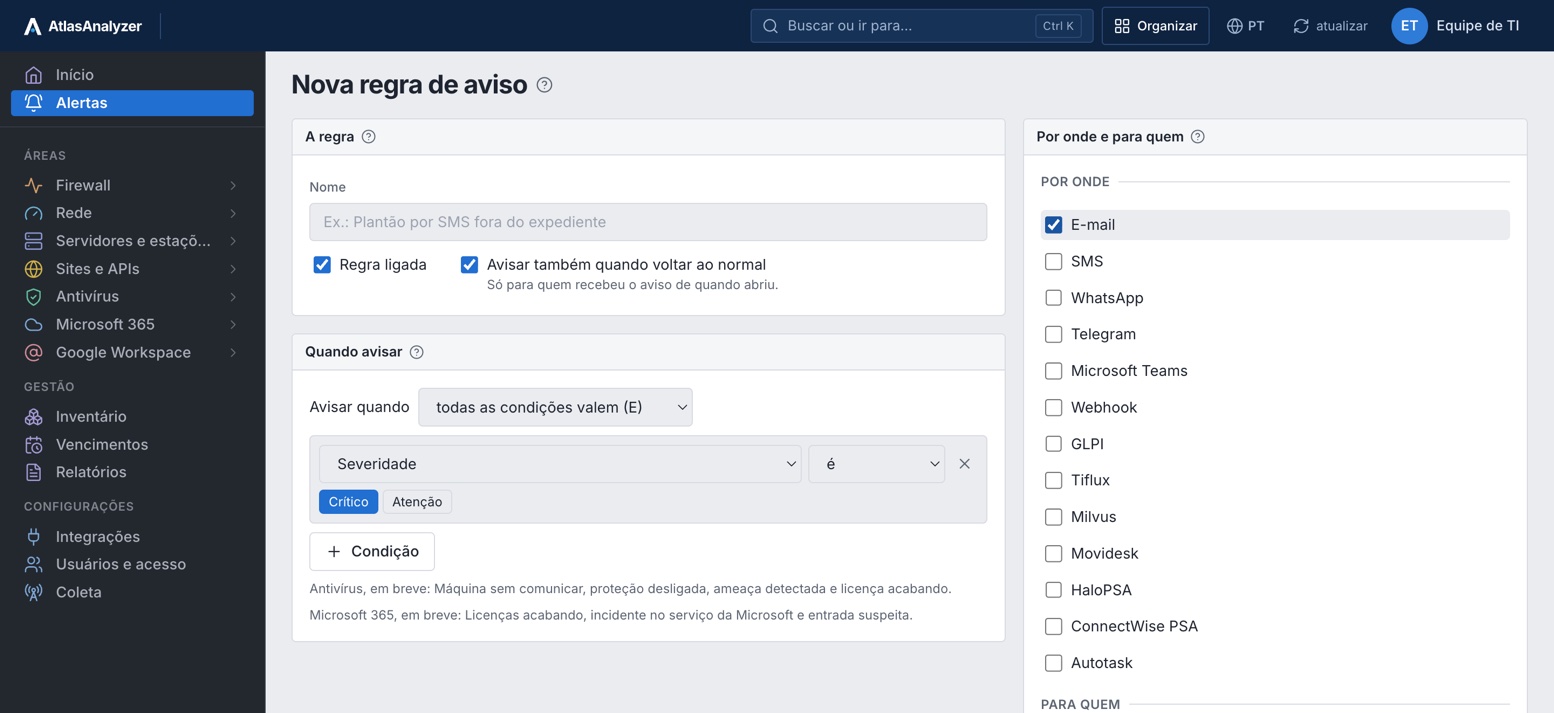
Reglas de aviso
Combine área, disparador, severidad, dispositivo, texto, día y horario, y elija los canales y quién recibe.
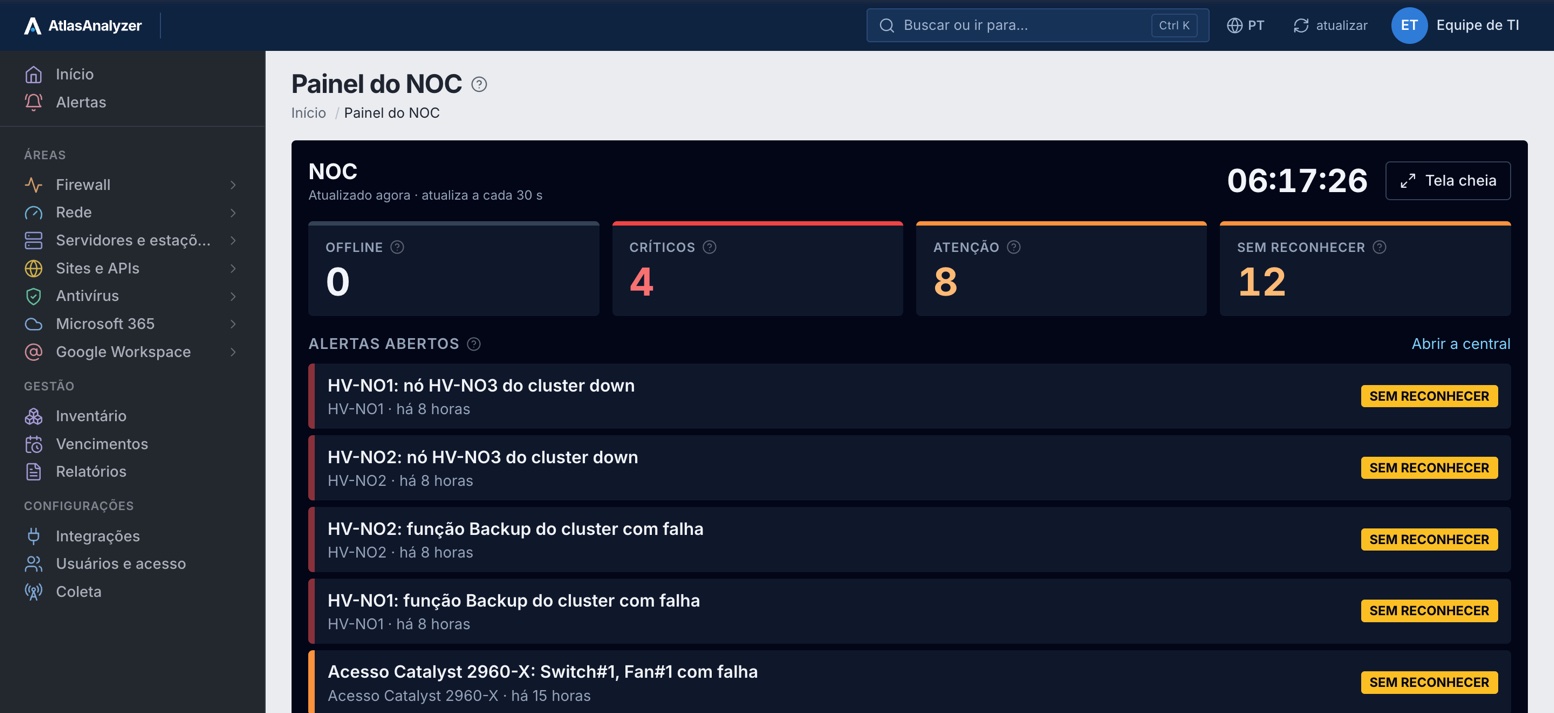
Panel del NOC
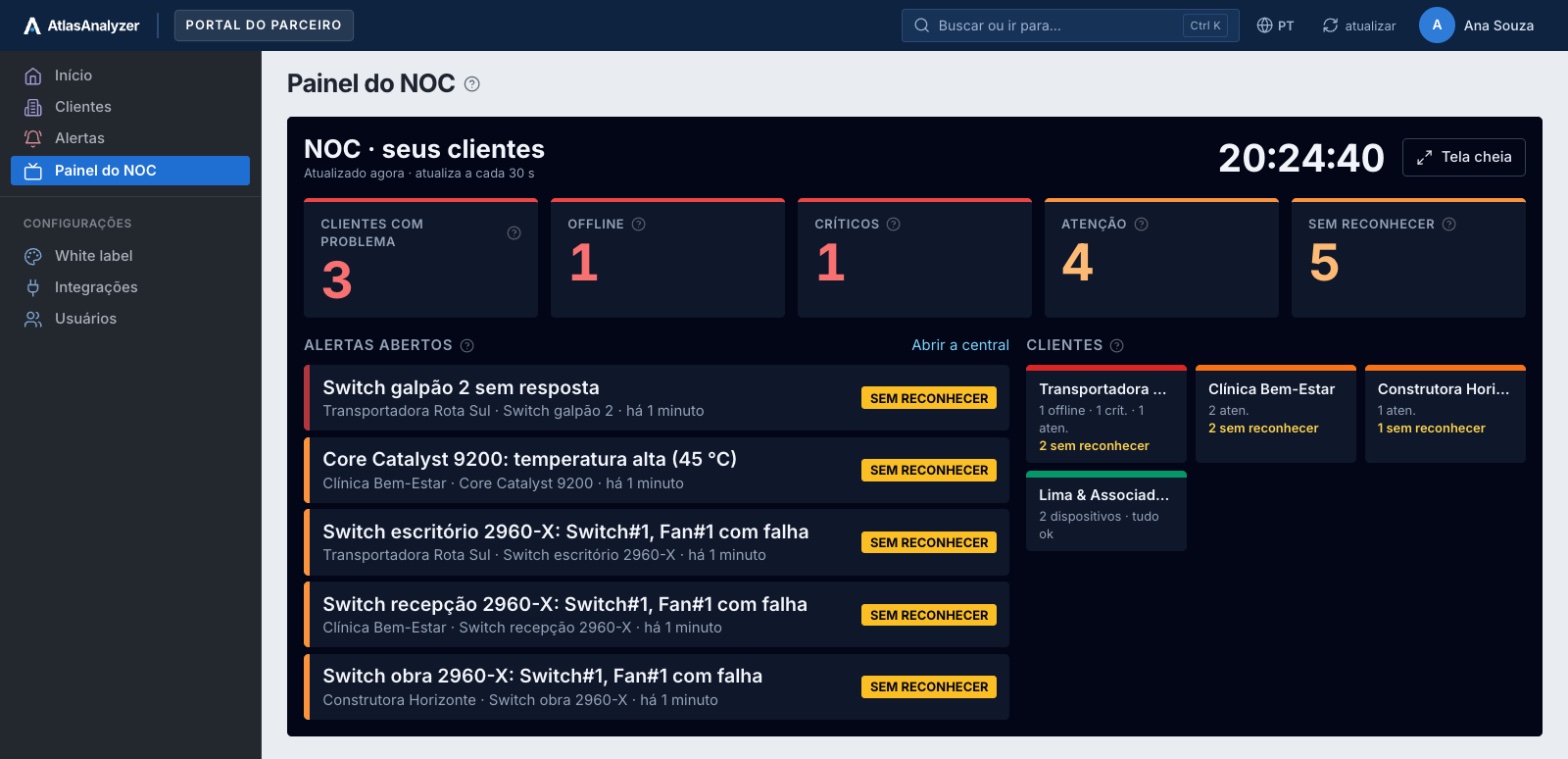
Para el videowall: lo que está offline, los críticos, lo que pide atención y lo que nadie reconoció, actualizado cada 30 segundos.
Para MSP
El partner ve las alertas de todos los clientes en un solo lugar, con el NOC de la cartera y un sistema de tickets para todos.
Vea Alertas y NOC con los datos de su entorno
Todo lo que AtlasAnalyzer hace con las alertas de todas las áreas, del aviso al ticket, en 26 funciones.
Las alertas de todas las fuentes juntas, con el origen, la severidad y el estado de cada una.
La alerta se abre cuando aparece el problema y queda resuelta cuando el dispositivo se normaliza.
Quién asumió cada alerta, los comentarios y el historial hasta que se resolvió.
Con el firewall offline, los dispositivos detrás de él no avisan: solo llega la alerta de la causa.
Dispositivo offline, interfaz, VPN y enlace SD-WAN down, SLA incumplido en el enlace, HA, licencia por vencer y syslog detenido.
CPU, memoria, disco lleno o llenándose, servicio detenido, IIS, AD, Exchange, clúster, SQL Server con poca memoria, bloqueos, base de datos offline o backup atrasado y VM de Hyper-V crítica.
Offline, lento, fuera de lo normal, certificado y dominio por vencer y SLA del mes incumplido.
Protección detenida, antivirus desactualizado y equipo sin comunicarse con la consola.
Servicio down o degradado, licencias agotadas, suscripción por vencer y sincronización con el AD detenida.
El suyo, sobre cualquiera de las 61 métricas recopiladas (uso del enlace, conexiones de SQL Server, tóner, autonomía del UPS), con la vista previa de las últimas 24 h.
Quién recibe el aviso y cuándo, combinando área, disparador, severidad, dispositivo, texto, día y horario.
Correo, SMS, WhatsApp, Telegram, Microsoft Teams y webhook.
Sin reconocimiento en el plazo, el aviso sube al siguiente del turno de guardia.
La alerta debe seguir abierta algunos minutos: el enlace que parpadea y vuelve no avisa.
Quien recibió el aviso del problema también recibe cuando se normaliza.
Cada contacto recibe en su idioma y en su zona horaria.
Qué se envió, a quién, por qué canal y si llegó.
La alerta abre el ticket en GLPI, Tiflux, Milvus, Movidesk, HaloPSA, ConnectWise o Autotask, con la prioridad según la severidad.
Asumido y escalamiento se vuelven seguimiento, y la solución va al ticket cuando la alerta se resuelve.
Ventanas en las que los dispositivos no abren alertas ni cuentan en la disponibilidad.
CPU, memoria, disco, inodos, colas, SQL Server, Hyper-V, latencia y pérdida con el límite de cada dispositivo.
Pantalla completa para videowall, actualizada cada 30 segundos, con lo que está offline y lo que nadie reconoció.
El tiempo medio para asumir y para resolver las alertas, en el período y en el informe.
De cada dispositivo, enlace y sitio, listos para el informe del mes.
El partner ve las alertas de todos los clientes en un solo lugar, con el NOC de la cartera.
Un sistema de tickets para toda la cartera, con la entidad o el cliente de cada uno.
Alerta operativa: dispositivo offline, VPN down, disco lleno, licencia por vencer.
Cada recolección abre y cierra las suyas, con los límites de cada dispositivo.
Qué avisa, por qué canal y a quién.
Rotación o turnos, con sustituciones; sin reconocimiento, el aviso sube en la escala.
La alerta se vuelve ticket y el ticket acompaña la alerta.
Cada envío queda registrado: qué fue, para quién, por qué canal y si llegó.
El aviso de apertura y el de resuelto, en el idioma de quien recibe
Un mensaje corto con el dispositivo y lo que pasó
El aviso por la plantilla de mensaje de AtlasAnalyzer
El aviso en un grupo o para una persona
Una tarjeta en el canal del equipo, con el color de la severidad
JSON firmado (HMAC-SHA256) para apertura, asumido, escalamiento y resuelto
GLPI, Tiflux, Milvus, Movidesk, HaloPSA, ConnectWise PSA y Autotask: abre el ticket con la prioridad según la severidad; asumido y escalamiento se vuelven seguimiento, y la solución va cuando la alerta se resuelve
Sí. Cuando el dispositivo se normaliza, la alerta queda resuelta, y quien recibió el aviso recibe el de resuelto.
La regla puede esperar unos minutos antes de avisar: lo que vuelve en ese tiempo no avisa.
No. AtlasAnalyzer es de observabilidad: las alertas son operativas.
Sí. El partner ve las alertas de toda la cartera y usa un sistema de tickets para todos los clientes.
En AtlasAnalyzer Monitor y en Analytics.
En una demostración de 30 minutos, nuestro equipo le muestra AtlasAnalyzer con datos de ejemplo de las fuentes que usted usa.
